FinTech Factoring & Lakehouse Architecture
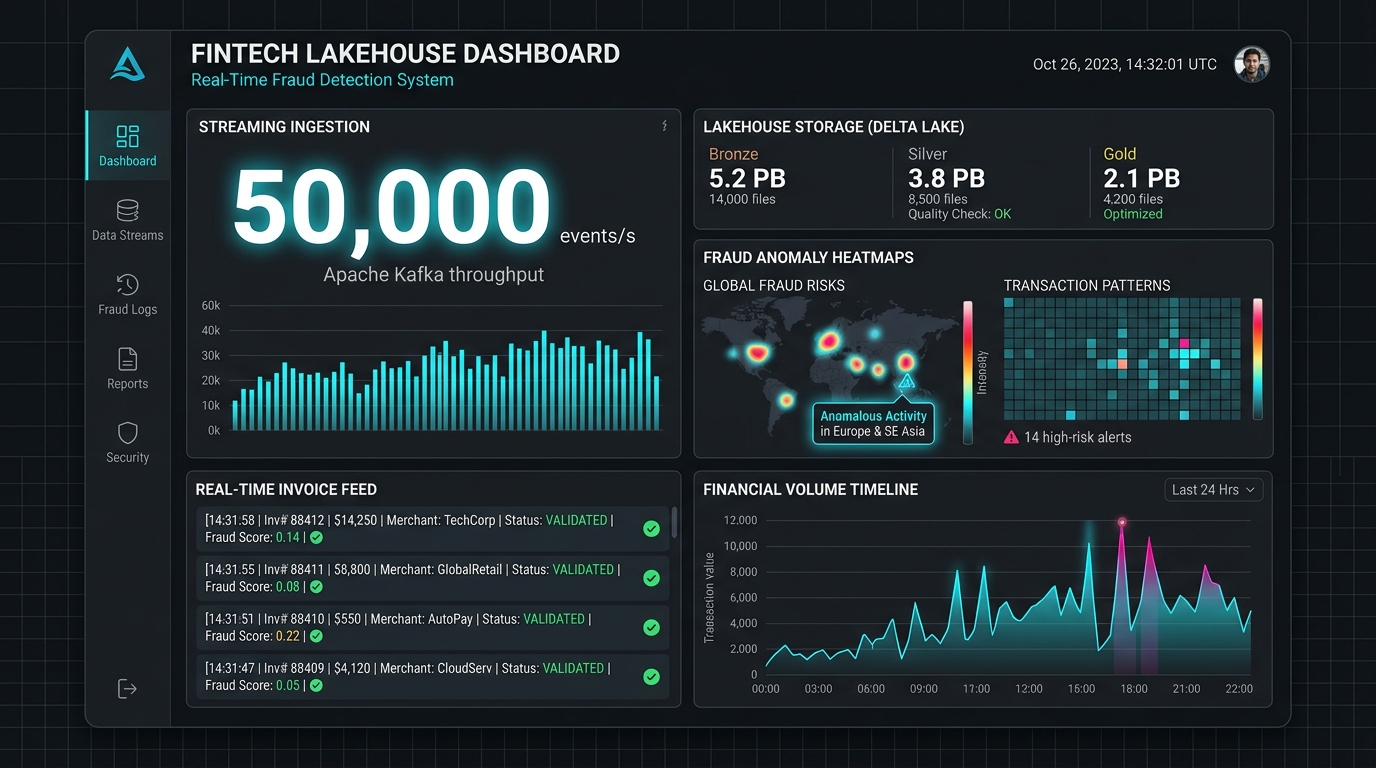
Arquitectura inspirada en Lakehouse con ingesta de eventos, almacenamiento Medallion en Delta Lake y modelado dimensional para operaciones de factoring.
Software Engineer | Data & AI
Ingeniero de Software enfocado en el desarrollo de sistemas impulsados por datos e inteligencia artificial. Con experiencia práctica en analítica de datos, flujos ETL, bases de datos y desarrollo backend, expandiendo activamente capacidades en Data Engineering, Machine Learning y AI Agents.
Software Engineering es la base sobre la cual diseño y construyo plataformas de datos y sistemas de inteligencia artificial.
Clean Code, POO, DDD, diseño de APIs RESTful, modelado relacional y control de versiones con Git como cimiento de todo sistema.
Consultas complejas en SQL, pipelines ETL, Data Warehousing, tableros en Power BI y automatización de calidad de datos.
Ingesta estructurada con Apache Kafka, transformaciones analíticas con dbt y Spark, y almacenamiento por capas Medallion.
Modelos predictivos supervisados, explicabilidad SHAP, asistentes RAG con bases vectoriales y flujos con agentes autónomos.
Ingeniero de Software que une el rigor del desarrollo de software con la analítica de datos aplicada y el diseño de sistemas de Inteligencia Artificial.
Software Engineer | Data & AI
Soy Ingeniero de Software egresado de la Universidad Peruana de Ciencias Aplicadas (UPC). Mi enfoque profesional parte de una base sólida en ciencias de la computación y desarrollo de software —arquitectura limpia, principios SOLID, diseño de APIs, bases de datos relacionales y control de versiones— para aplicarlos directamente a la gestión y explotación inteligente de datos.
Cuento con experiencia práctica en analítica de datos, consultas SQL complejas, pipelines ETL, modelado dimensional y tableros interactivos en Power BI. Sobre estos fundamentos, diseño y prototipo proyectos ambiciosos en Data Engineering (Lakehouse, Kafka, Spark), Machine Learning (Scikit-Learn, XGBoost, SHAP) y GenAI (sistemas RAG con Qdrant y experimentación con flujos agénticos).
Desarrollo de microservicios y APIs modulares con FastAPI, Spring Boot y C# .NET Core, aplicando Clean Architecture, DDD y pruebas de software.
Experiencia práctica en consultas SQL avanzadas, pipelines ETL, modelado dimensional (Data Warehousing), tableros en Power BI y automatización de datos.
Diseño de flujos de datos estructurados, desacoplamiento con Apache Kafka, transformaciones analíticas con dbt/Spark y capas Medallion.
Modelos predictivos con Scikit-Learn/XGBoost, búsqueda semántica vectorial, asistentes RAG con LangChain/Qdrant y experimentación con tool use y agentes.
"Bases de software sólidas para construir datos confiables y modelos explicables."
Separación clara entre mi trabajo real con datos/software y mi formación académica. Los proyectos personales y prototipos se detallan de forma independiente como casos de estudio.
Trabajo práctico en el ciclo de vida de datos analíticos: extracción desde fuentes operacionales, diseño de flujos ETL, modelado dimensional y generación de reportes ejecutivos.
Diseño y desarrollo de microservicios, APIs de datos y aplicaciones multiplataforma con estándares de código limpio y arquitectura modular.
Formación académica integral en fundamentos de ciencias de la computación, ingeniería de software, arquitectura de sistemas y gestión de datos.
¿Buscas ver implementaciones de código, arquitecturas y prototipos técnicos? Explora la sección de Proyectos estructurada como pequeños casos de estudio.
Cómo pienso y diseño sistemas de datos como Software Engineer: flujo modular Sources → Processing → Storage → Intelligence → API → Application.
Bases relacionales transaccionales (OLTP), APIs REST, telemetría IoT y documentos no estructurados (facturas, PDF).
Desacoplamiento elástico con Apache Kafka y recolección programada para absorber ráfagas sin degradar el origen.
Transformaciones SQL modulares con dbt Core, validaciones de esquema continuas y pipelines reproducibles con Python.
Capas organizadas (Bronze histórico, Silver limpio y Gold métricas) en Delta Lake, DuckDB y Data Warehouses.
Inferencia con modelos supervisados Scikit-Learn/XGBoost, explicabilidad SHAP e indexación vectorial densa con Qdrant.
Endpoints REST documentados con OpenAPI/Pydantic, microservicios backend y tableros interactivos para toma de decisiones.
Colocar un buffer de eventos (como Kafka) aísla a las fuentes transaccionales de fallas o lentitud en los consumidores downstream, garantizando idempotencia y tolerancia a fallos.
Bronze garantiza auditoría total al almacenar datos crudos sin modificar; Silver aplica reglas de negocio y deduplicación; Gold expone esquemas en estrella optimizados para consulta analítica.
Validar esquemas en los límites del sistema (con Pydantic en APIs y tests automáticos en dbt) previene que datos corruptos o incompletos afecten los modelos analíticos o la experiencia de usuario.
La recuperación aumentada (RAG) mantiene los datos actualizados al instante, reduce alucinaciones mediante citas explícitas a documentos fuente y es mucho más costo-eficiente que re-entrenar LLMs.
"I am actively building and experimenting with AI systems and agents."
Avanzando progresivamente hacia la ingeniería de inteligencia artificial y flujos agénticos sobre una base sólida de ingeniería de software.
Indexación semántica de documentos no estructurados con bases de datos vectoriales (Qdrant / Chroma), segmentación contextual y recuperación aumentada libre de alucinaciones.
Integración de LLMs con APIs REST, consultas dinámicas a bases de datos SQL y ejecución controlada de herramientas para convertir modelos en agentes operativos.
Experimentación con arquitecturas de agentes autónomos: bucles de planificación y ejecución, descomposición de tareas complejas y memoria conversacional.
Exploración de estándares emergentes para conectar modelos de IA con herramientas del sistema de archivos, repositorios y servicios externos de manera segura y modular.
Trato las aplicaciones con LLMs y agentes como sistemas de software rigurosos: requieren validación estricta de esquemas (Pydantic / JSON Schema), manejo de timeouts, desacoplamiento, trazabilidad y control de costos en lugar de cajas negras.
Selección de proyectos organizados como pequeños casos de estudio: problema, solución, arquitectura end-to-end, decisiones técnicas y código verificable.
Arquitectura inspirada en Lakehouse con ingesta de eventos, almacenamiento Medallion en Delta Lake y modelado dimensional para operaciones de factoring.
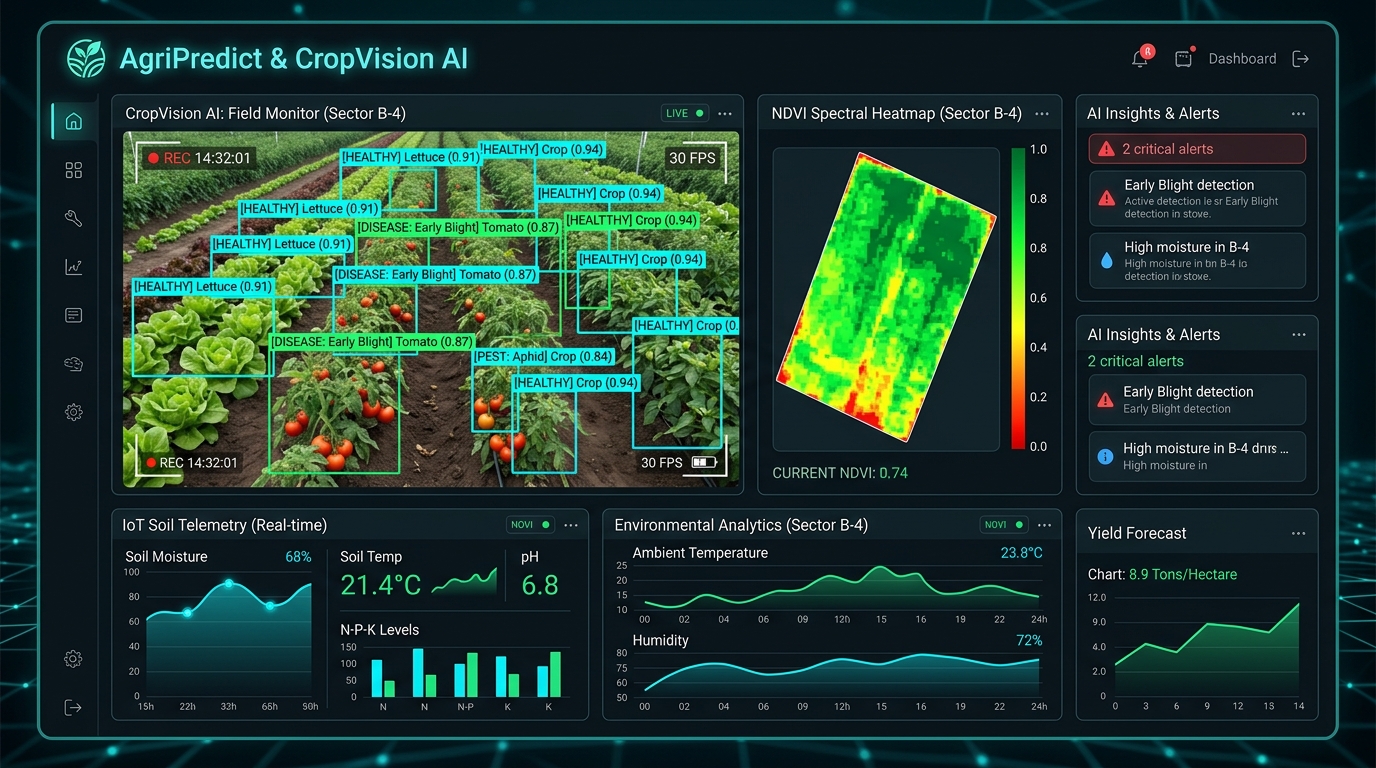
Plataforma web y móvil para monitoreo agrícola con arquitectura DDD, integración de telemetría de campo y prototipo de detección foliar con YOLOv8.
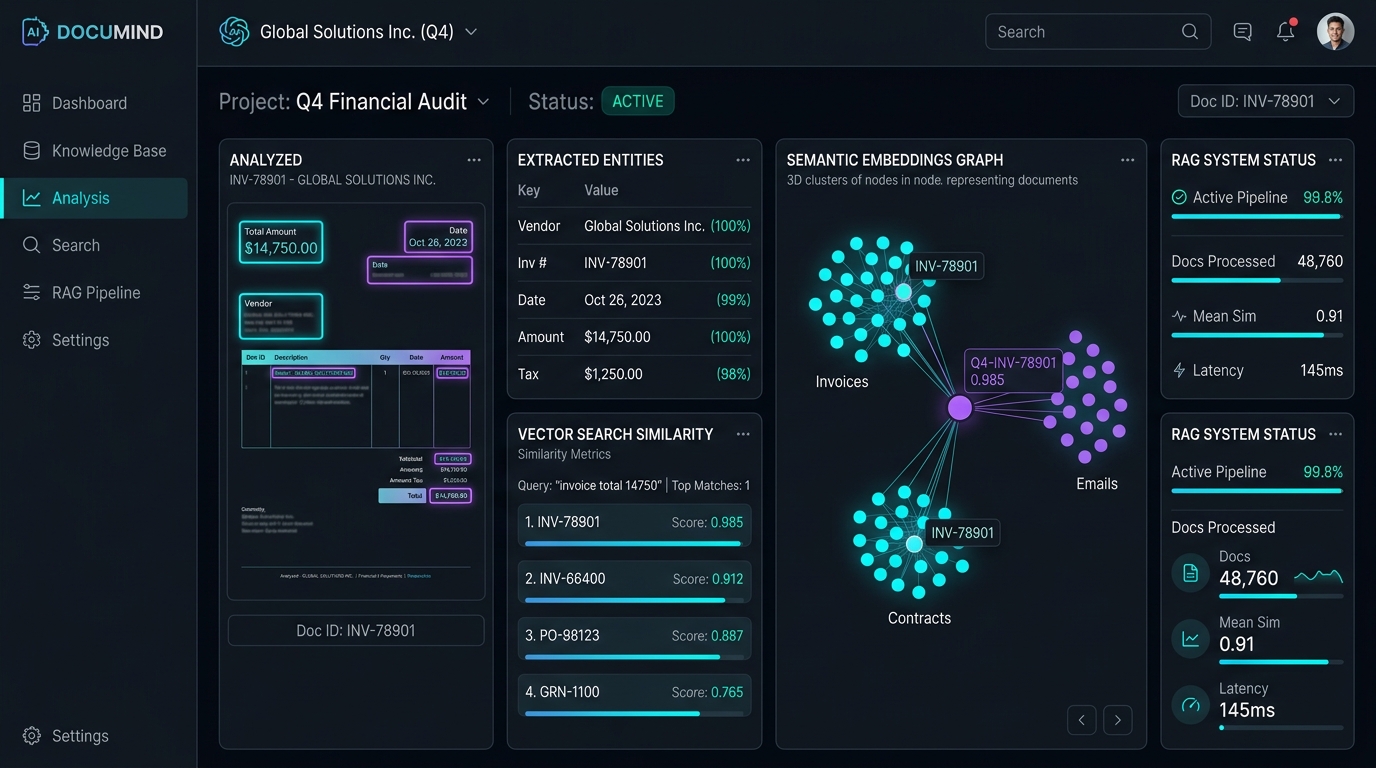
Prototipo de asistente con recuperación semántica aumentada (RAG) y bases vectoriales para consulta y validación estructurada de comprobantes fiscales.
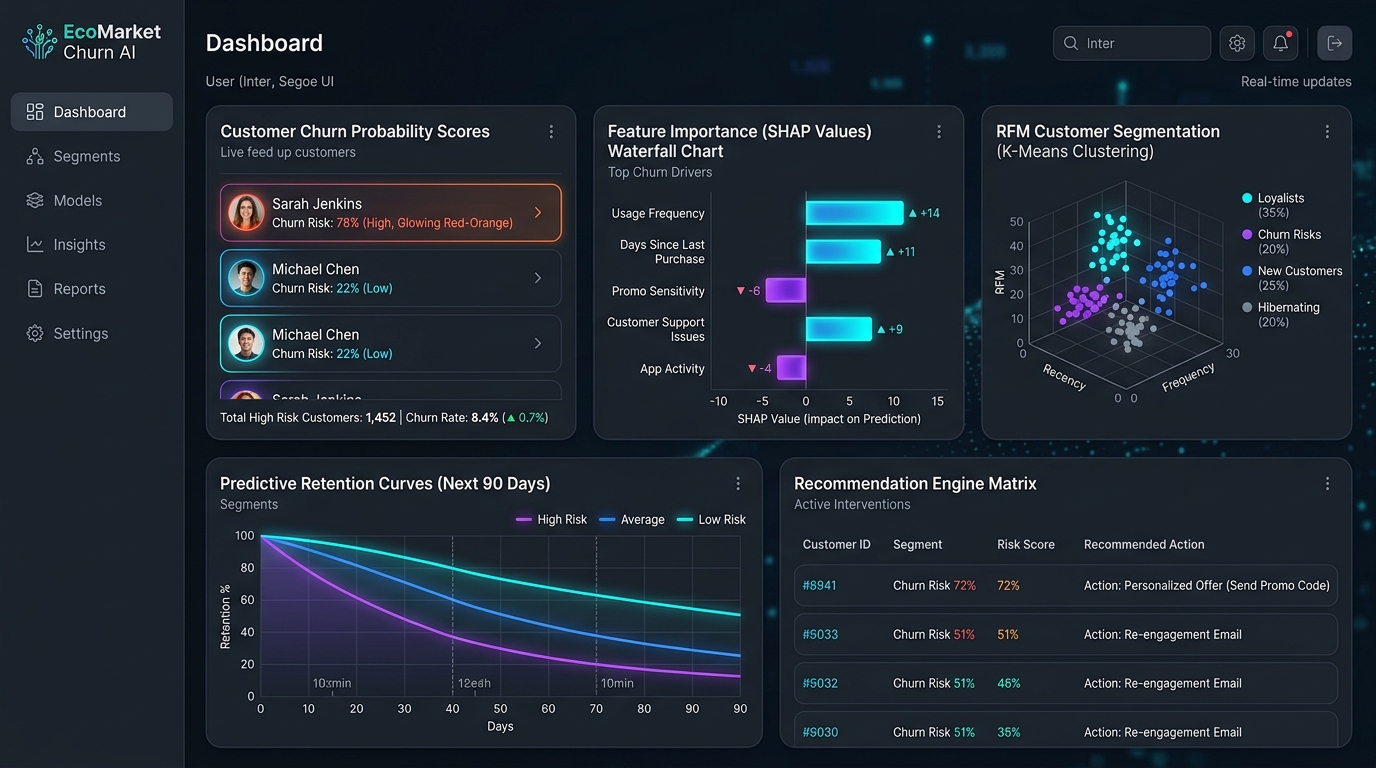
Aplicación de comercio electrónico con backend en Spring Boot, frontend Angular e integración de análisis de comportamiento y retención de clientes.
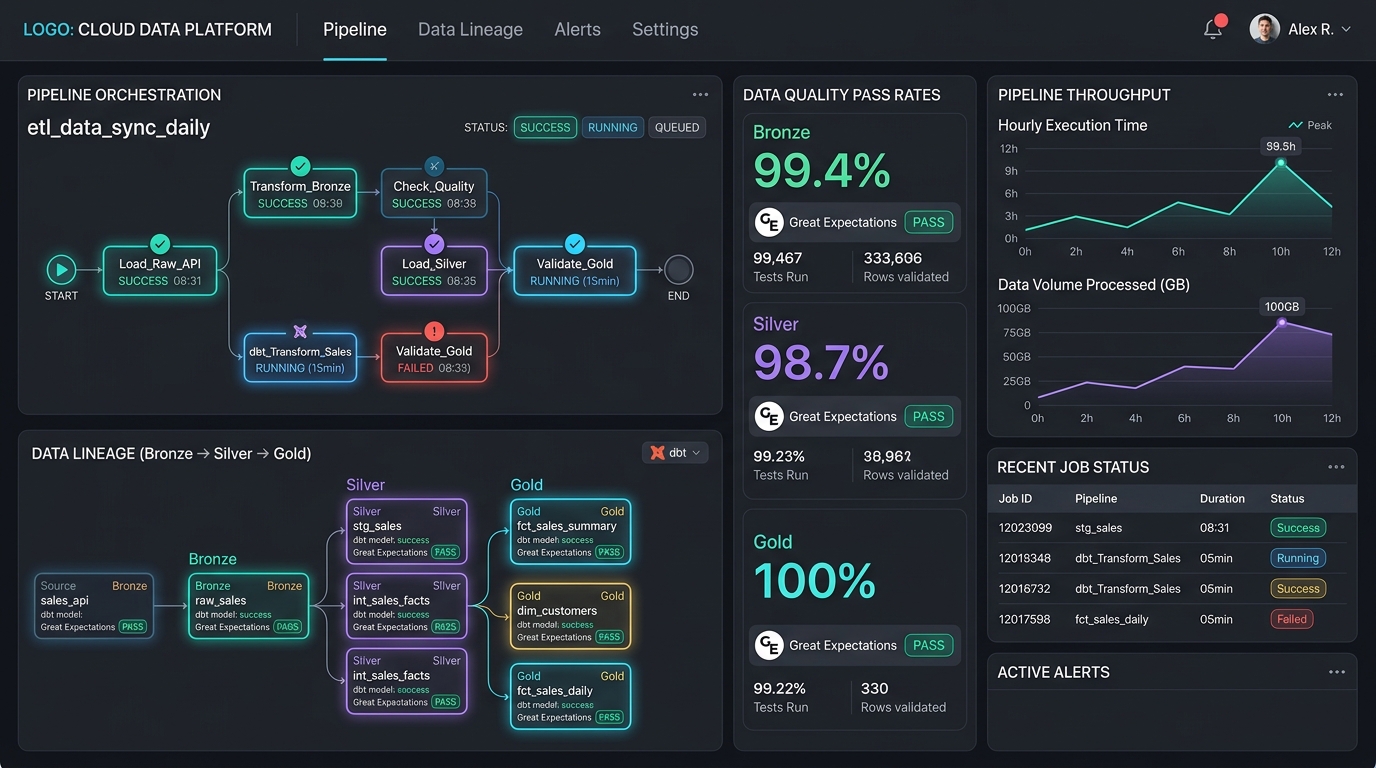
Prototipo de pipeline analítico orquestado con Apache Airflow, transformaciones SQL en dbt Core, validación de calidad y modelado dimensional.
Prototipos complementarios de Machine Learning y desarrollo de software.
Prototipo de evaluación de riesgo crediticio mediante modelos supervisados y análisis de explicabilidad con SHAP para decisiones transparentes.
Organizado de forma transparente por áreas de aplicación, diferenciando tecnologías de experiencia real, proyectos construidos y áreas en aprendizaje activo.
Bases sólidas de ingeniería de software, modelado de datos y desarrollo de APIs.
Disponible para oportunidades en roles como Junior Data Engineer, Data Analyst, Junior AI Engineer o Software Engineer enfocado en Datos & IA. Abierto a conversar sobre desafíos técnicos y proyectos de impacto.